Идея проекта
В своём проекте я решила исследовать, как генеративная нейросеть может визуализировать сновидения и помещать меня внутрь придуманных сцен. Мне хотелось создавать изображения по текстовому описанию, сохраняя собственную внешность в разных обстоятельствах и образах.Сны позволяют соединять повседневные ситуации с фантастическими событиями: обычный ужин может превратиться в необычную сцену, а знакомый образ — оказаться на Луне. Поэтому я выбрала формат серии автопортретов, вдохновлённых реальными и воображаемыми сновидениями.
Датасет
Для обучения я подготовила датасет из 12 собственных фотографий. В него вошли портреты с разными ракурсами, выражениями лица, освещением и фоном. Изображения были приведены к квадратному формату 1024 × 1024 пикселя.К фотографиям были добавлены текстовые подписи с описанием видимых деталей. Во всех подписях использовалось сочетание nstrm woman, которое затем включалось в запросы при генерации.
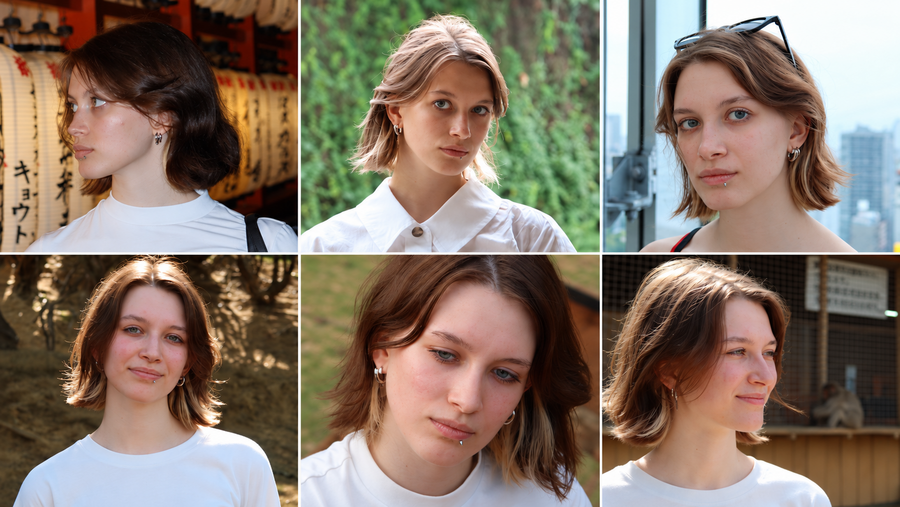
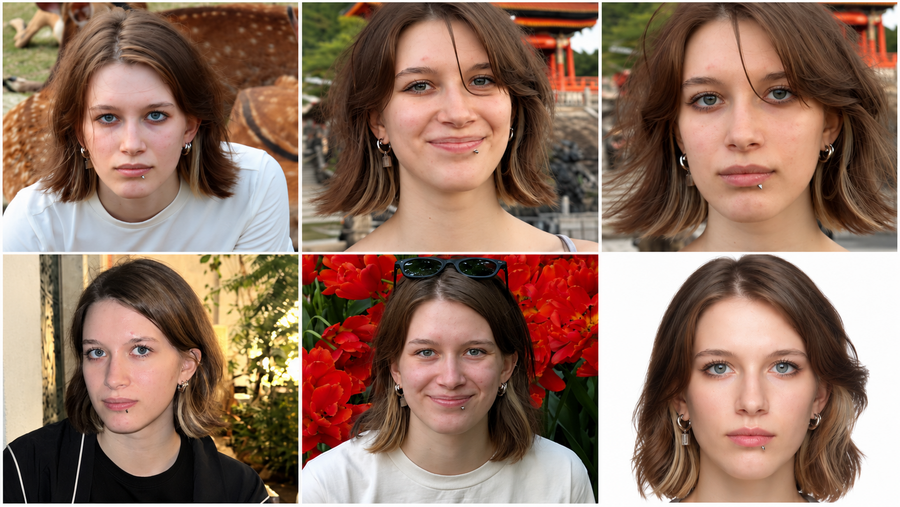
Примеры собственных фотографий, использованных для обучения.
При отборе я обращала внимание на видимость лица и разнообразие ракурсов. По исходным портретам модель должна была усвоить особенности внешности, которые затем проверялись в новых сюжетах.
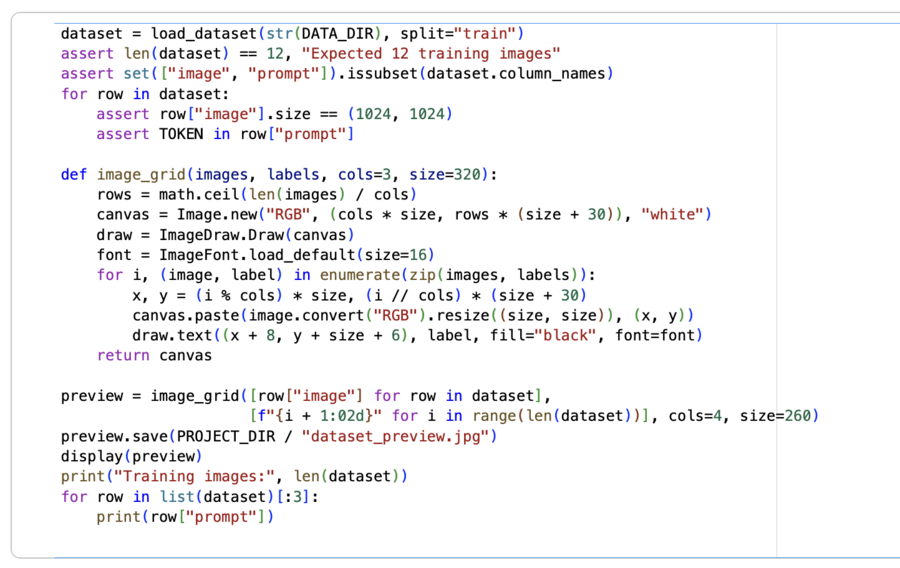
Проверка датасета и текстовых описаний перед обучением.
Процесс обучения модели
Работа выполнялась в Google Colab с использованием GPU. В качестве основы я использовала Stable Diffusion XL 1.0, а для адаптации под собственную внешность — DreamBooth с LoRA. При таком подходе обучаются небольшие дополнительные матрицы, которые затем подключаются к базовой модели.В моей конфигурации обучались LoRA-параметры UNet и текстовых энкодеров. Для экономии памяти применялись смешанная точность fp16, накопление градиентов и оптимизатор Adam в 8-битном варианте. Код обучения был подготовлен на основе учебного примера и скрипта train_dreambooth_lora_sdxl.py из библиотеки Diffusers.Обучение включало 400 шагов. Промежуточные состояния сохранялись через каждые 100 шагов. После завершения были сохранены веса pytorch_lora_weights.safetensors. Их можно повторно загрузить в базовую модель и использовать для генерации без нового обучения.
Проверка видеокарты перед началом работы
Эта ячейка показывает, какая видеокарта доступна в Google Colab. Это видеокарта используется для обучения модели и создания изображений.
Выбор модели и настройка папок проекта
Здесь указаны название проекта, базовая модель Stable Diffusion XL и папки для файлов. Также задаётся обозначение nstrm woman, которое в будущем используется в подписях к фотографиям и запросах для генерации. Код создаёт нужные папки и проверяет наличие сохранённой LoRA.
Настройки перед обучением модели
В этой ячейке я указала, где находятся фотографии и куда сохранить результат. Для обучения выбрала размер 512 × 512 пикселей и 400 шагов. Дальше эти настройки использовались при запуске обучения.
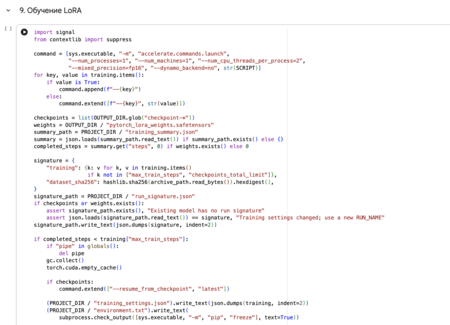
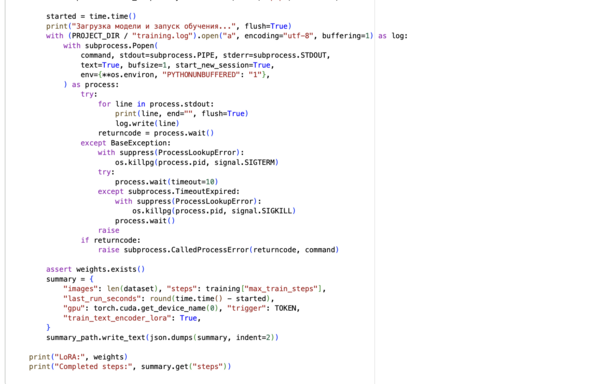
Запуск обучения на собственных фотографиях
Эта ячейка запускает обучение с выбранными настройками. Во время работы модель обрабатывает фотографии и их текстовые описания. Внизу ячейки отображается ход обучения. Мой запуск завершился после 400 шагов.После обучения сохранился файл с готовой LoRA. Затем я подключила его к Stable Diffusion и перешла к созданию изображений по описаниям снов. Сохранённый файл позволяет продолжать генерацию без повторного обучения.
Проверка портретного сходства
После обучения я сравнила тестовые изображения с исходными фотографиями. Основная трудность оказалась связана с точностью лица: в разных генерациях менялись пропорции, форма глаз и носа, причёска и воспринимаемый возраст. Поэтому сохранение общего портретного образа я оценивала отдельно от сходства с конкретным человеком.Чтобы дополнительно направить модель на мою внешность, я подключила готовый IP-Adapter FaceID Plus v2 для SDXL и использовала фотографию-референс. Этот компонент применялся при генерации; собственное обучение в проекте относилось к LoRA.Для проверки были сопоставлены четыре режима с одним текстовым запросом и одинаковым seed. Такое сравнение позволило посмотреть, как меняется изображение при подключении собственной LoRA и FaceID.
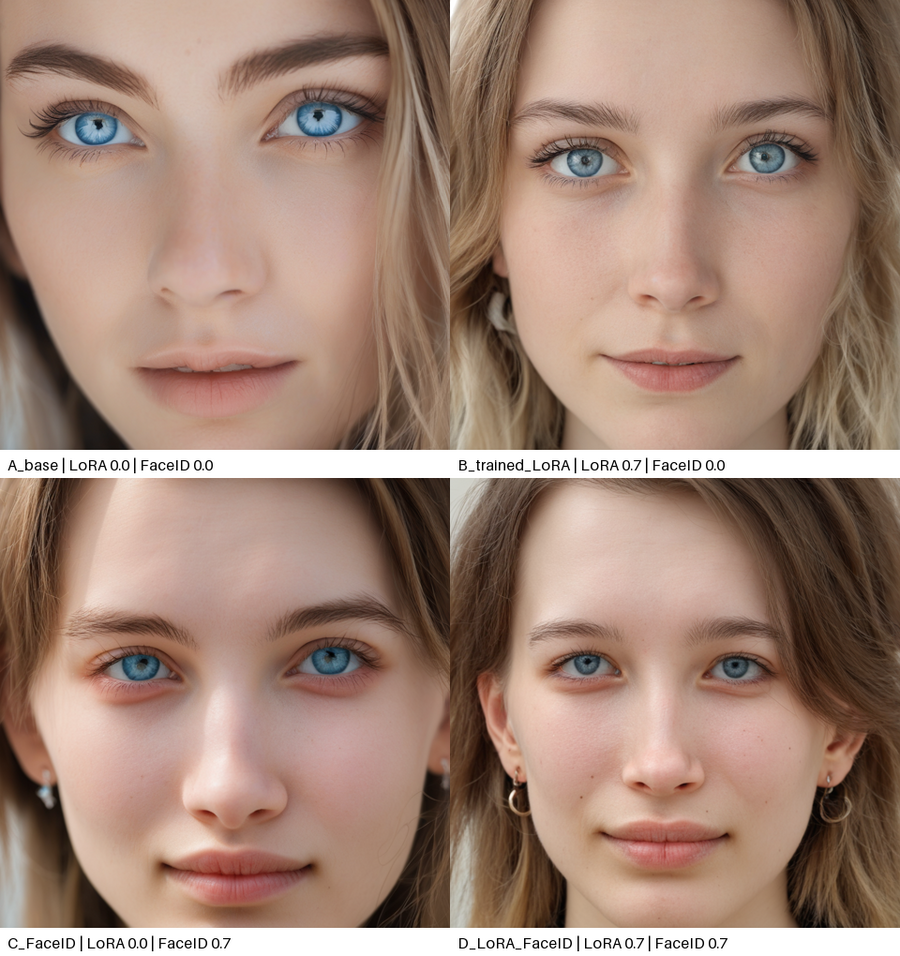
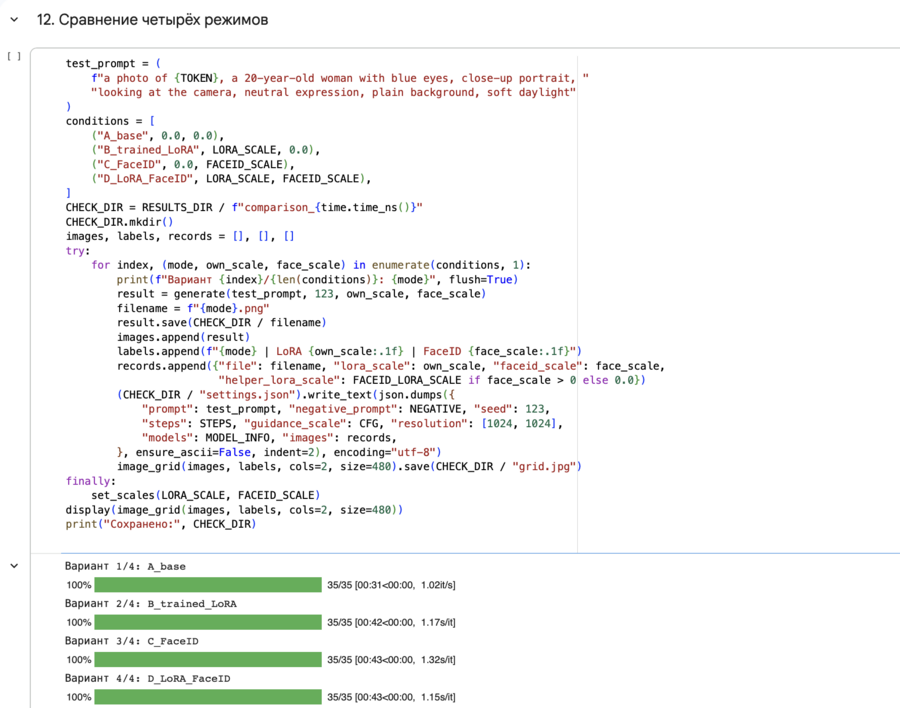
Сравнение четырёх режимов генерации при одинаковом запросе и seed 123
В тестовых результатах FaceID помогал приблизить отдельные признаки внешности, но стабильного совпадения лица достичь не удалось. Сходные волосы или голубые глаза сами по себе ещё не означали точный автопортрет. При оценке я также сравнивала длину лица, форму носа, посадку глаз и естественность кожи.Голубой цвет глаз дополнительно задавался в тексте запроса, поэтому его нельзя считать самостоятельным доказательством успешного обучения.
Подготовка сюжетов и генерация серии
Для серии я выбрала шесть сюжетов. Текстовое описание каждого кадра задавало место действия, одежду, действие и атмосферу. Во всех запросах сохранялся общий фрагмент, связанный с главной героиней: a photo of nstrm woman, a 20-year-old woman with blue eyes.Затем к этому фрагменту добавлялось описание конкретного сна. Такая структура позволяла менять содержание кадра, сохраняя одну задачу — перенести мой образ в новую ситуацию.При выборе изображений я ориентировалась на соответствие сюжету, сходство с исходными фотографиями и отсутствие заметных искажений. В итоговую публикацию входит по одному выбранному изображению на каждый сюжет. Точные запросы и значения seed сохраняются вместе с результатами.
Ссылка на блокнот: Открыть Google Colab
Итоговая серия изображений
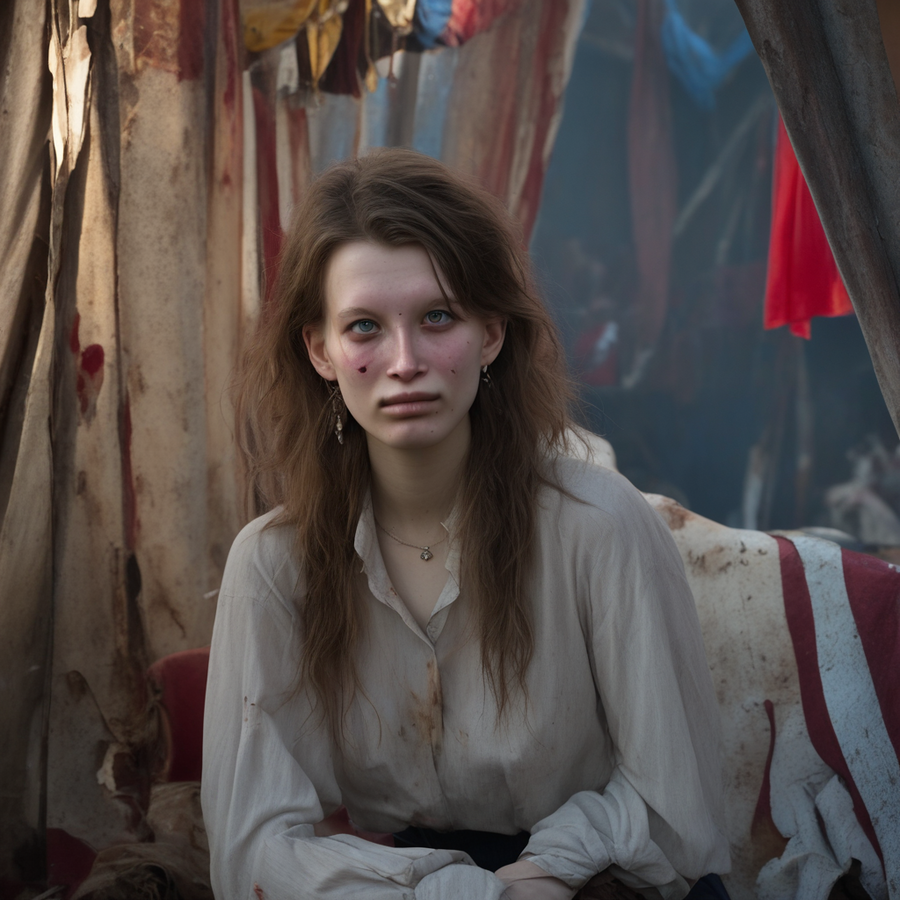
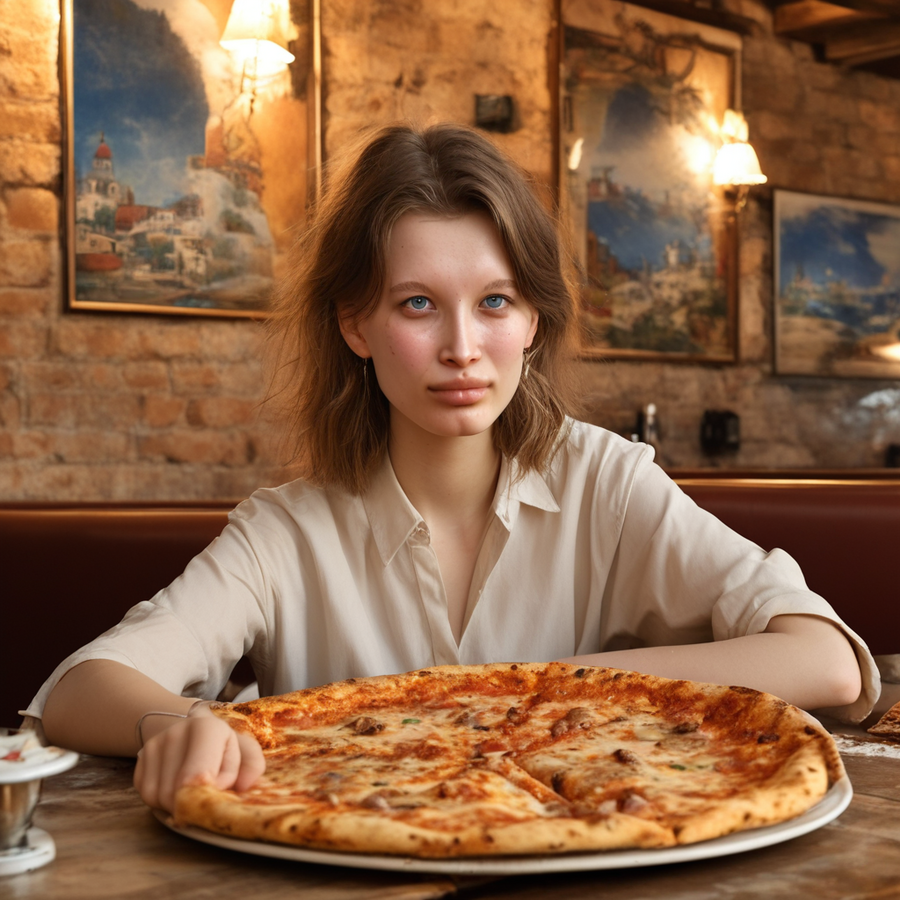
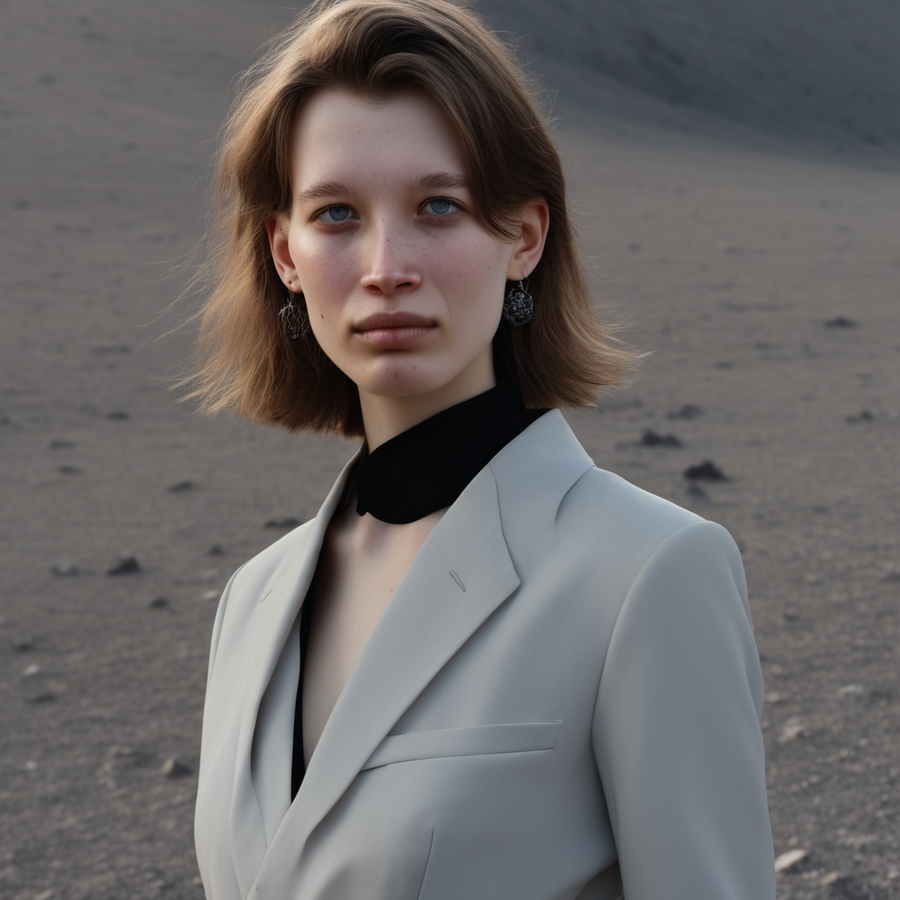
Я написала запросы, для генерации серии итоговых изображений:1. Сон с пиццей
Портрет по пояс: ем большой кусок пиццы в уютном итальянском ресторане. Тёплое золотистое освещение, парящие в воздухе кусочки пиццы, сюрреалистичная атмосфера сна. Без других людей.2. Джеймс Бонд на Луне
Портрет по пояс: стою на Луне в элегантном чёрном смокинге в стиле Джеймса Бонда. На тёмном небе светится Земля, вокруг лунная пыль и кинематографичное освещение. Без других людей.3. Мрачный цирк
Портрет по пояс: нахожусь внутри заброшенного мрачного циркового шатра. Жуткие клоунские декорации, сломанная карусель, красные занавесы, густой туман и мерцающие огни. Пугающая атмосфера. Без других людей.
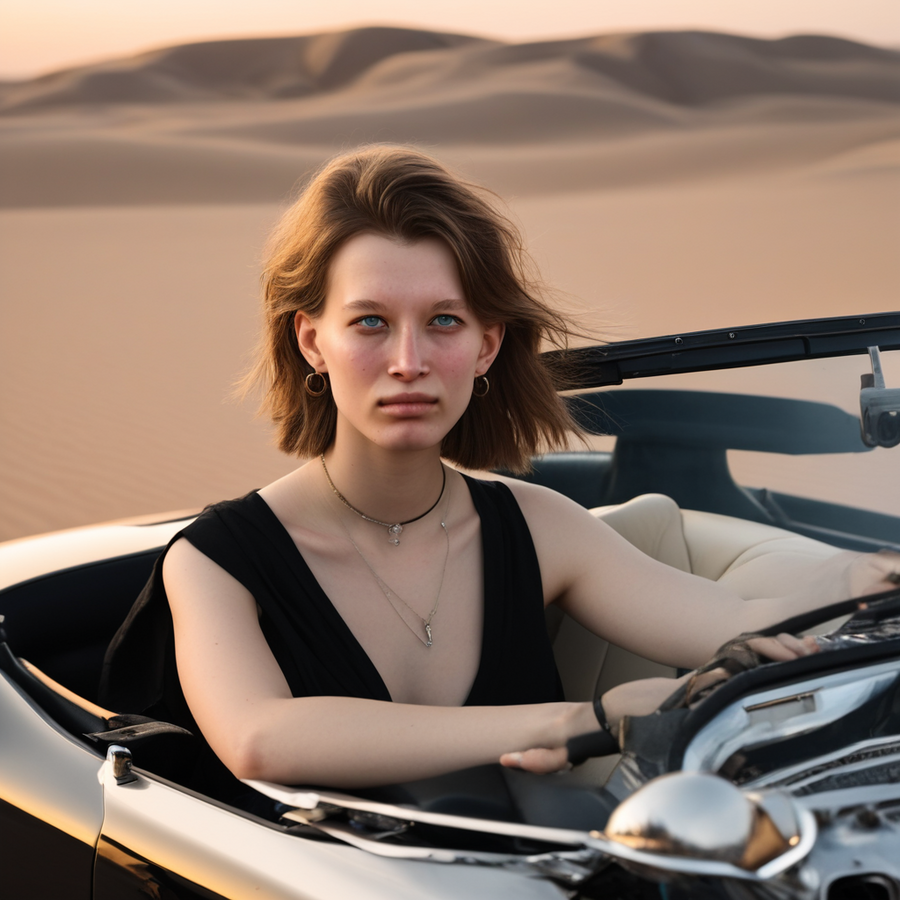
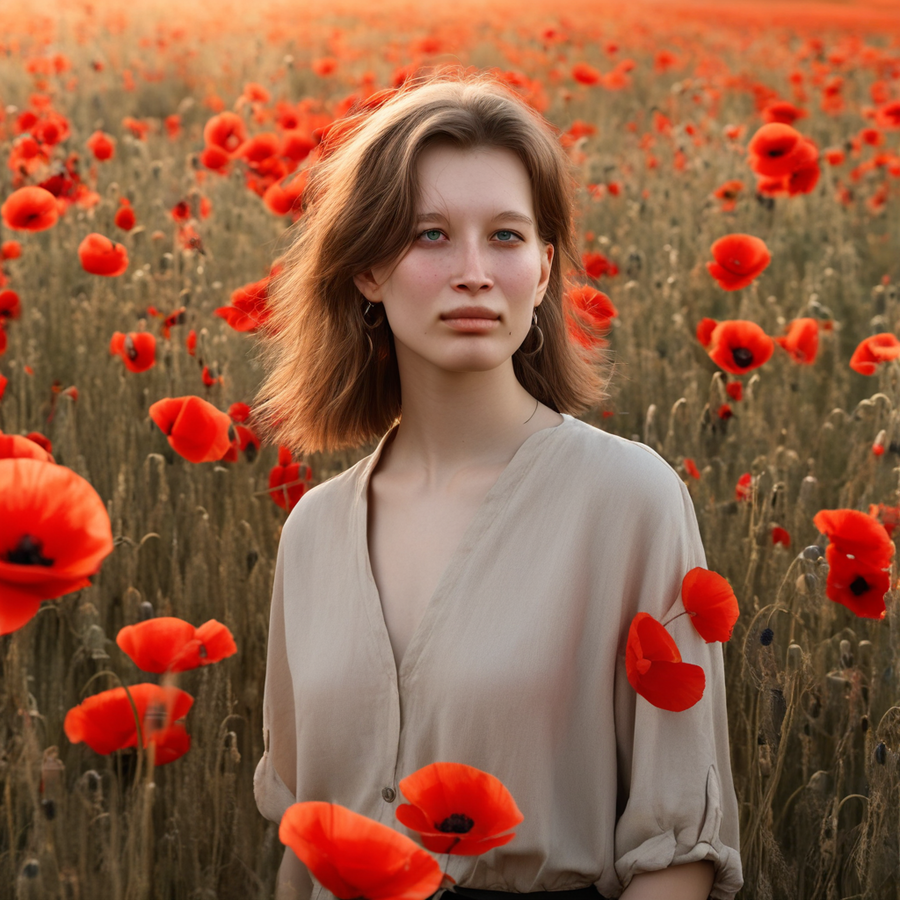
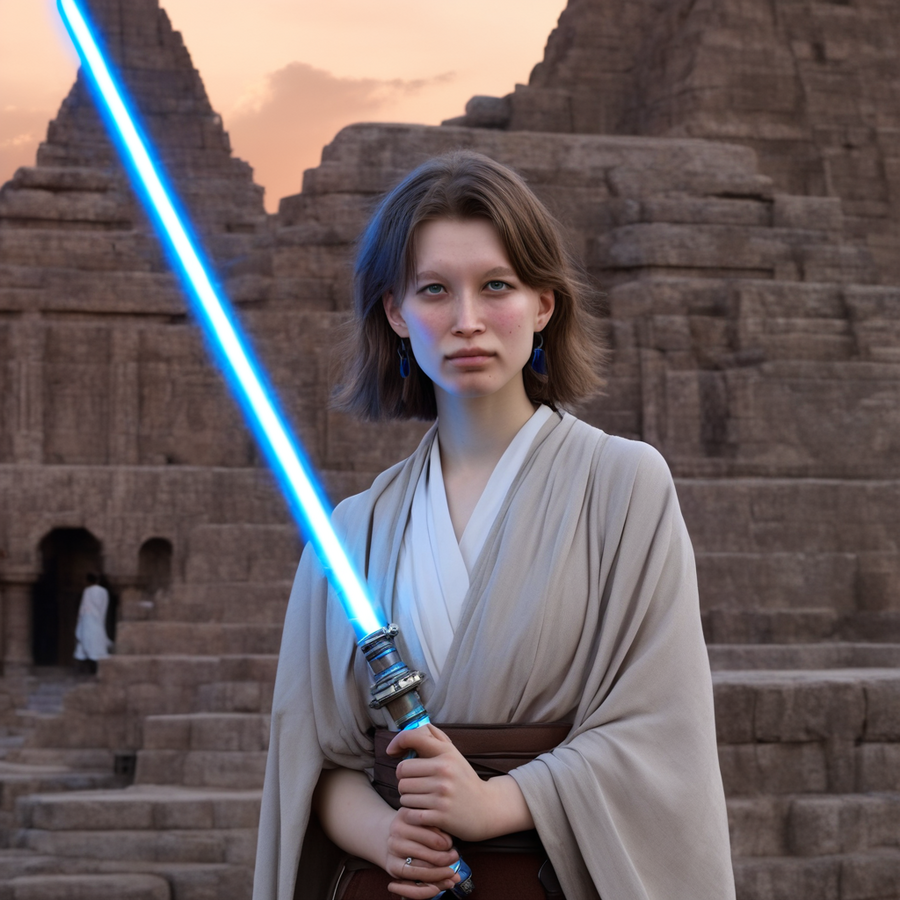
- Маковые поля
Портрет по пояс: стою посреди бескрайнего поля ярко-красных маков. Лёгкий ветер, золотистый закат, далёкие горы и мягкая, сказочная атмосфера сна. Без других людей.5. Сон джедая
Портрет по пояс: я в образе джедая, держу светящийся синий световой меч. Вокруг древний футуристический храм, вдали инопланетные горы, драматичное синее освещение и звёздное небо. Без других людей.6. Спорткар в пустыне
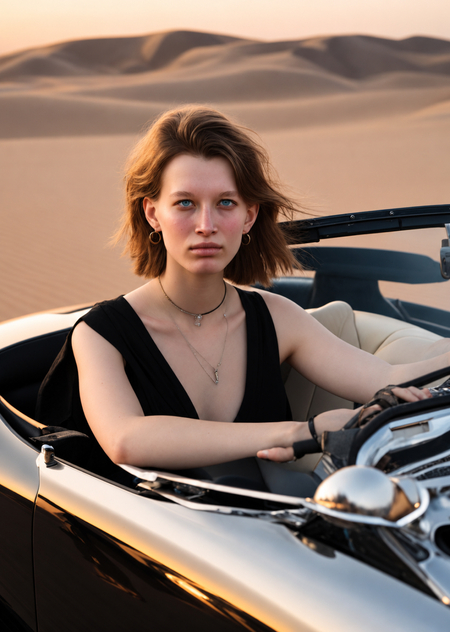
Портрет по пояс: еду за рулём роскошного чёрного спорткара через бескрайнюю пустыню. Золотистые песчаные дюны, пыльная дорога, эффектный закат и кинематографичная атмосфера. Без других людей.